Huawei presentó en su conferencia Huawei Connect 2026, celebrada en Shanghái, la siguiente etapa de su plataforma de cómputo para inteligencia artificial. La compañía amplía la familia Ascend 960 con sistemas pensados para entrenar y servir modelos de hasta 10 billones de parámetros y, al mismo tiempo, confirma que su hardware de IA de próxima generación se quedará dentro de China: no hay capacidad suficiente para atender la demanda interna, así que no habrá un despliegue internacional completo.
Ascend 960: el Atlas SuperPoD sube hasta 15.488 procesadores
Huawei detalló el roadmap de su Atlas 960 SuperPoD, que pasa de la configuración anterior de 8.192 procesadores a un máximo de 15.488 Ascend 960. La compañía cifra el rendimiento del sistema en 30 EFLOPS en FP8, con 4.460 TB de capacidad de memoria y un ancho de banda de interconexión de 34 PB/s. En entrenamiento, Huawei espera alcanzar los 15,9 millones de tokens por segundo. Tom’s Hardware sitúa el techo en FP4 en 120 EFLOPS para esos clústeres de 15.488 chips.
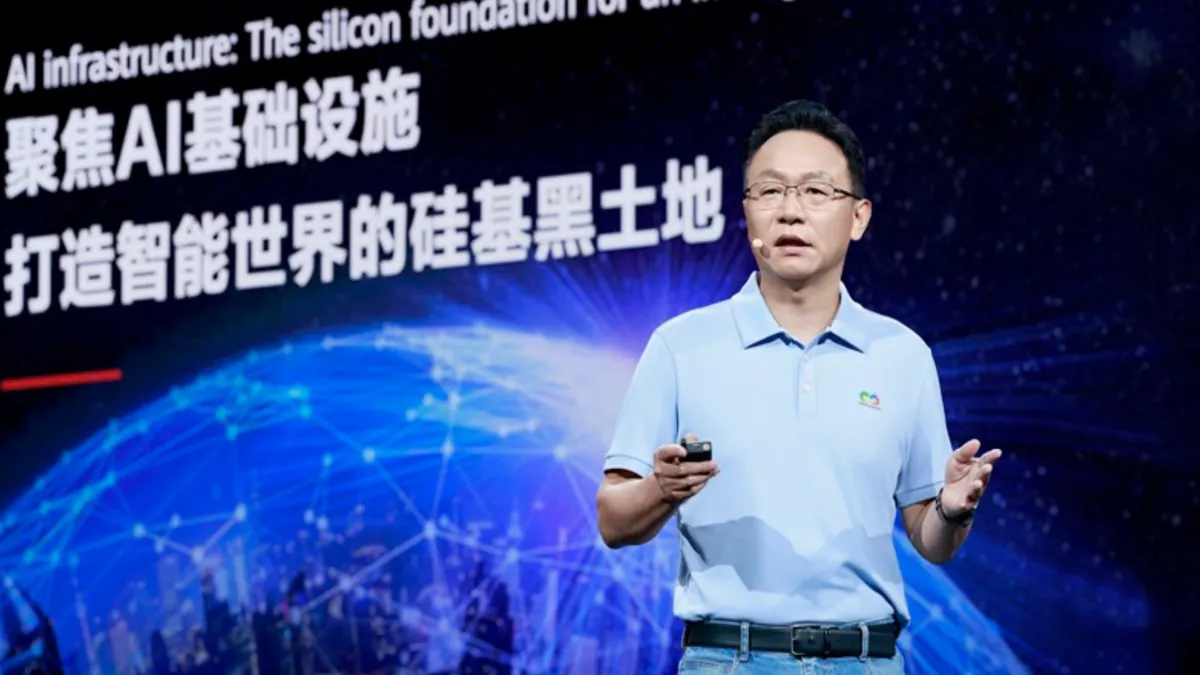
El calendario también se ha apretado: el Ascend 960DT llegará en el primer trimestre de 2027 y el 960PR en el tercero, ambos antes de lo previsto. David Wang, presidente rotatorio y vicepresidente del consejo de Huawei, resumió la estrategia durante la keynote: la compañía quiere mantener una cadencia de una generación al año y, gracias a la bautizada como ley de escalado Tau (τ), planea lanzar los Ascend 970 y 980 en 2028 y 2029 con el rendimiento duplicándose en cada salto.
UnifiedBus y óptica dentro del paquete
El otro pilar de la propuesta es UnifiedBus, la arquitectura de interconexión con la que Huawei enlaza procesadores, memoria y almacenamiento para reducir la sobrecarga de comunicación. En el Atlas 960E, la variante apoyada en esta tecnología, UnifiedBus conecta hasta 4.096 NPUs y les da acceso a memoria compartida a lo largo del SuperPoD.
Para sostener ese volumen de datos, Huawei combina UnifiedBus con la tecnología óptica Hi-ONE y con óptica near-package (NPO), que acerca los componentes ópticos a los procesadores. La compañía asegura que el 960E puede usar unas 5.500 unidades Hi-ONE en lugar de unos 48.000 módulos ópticos convencionales de 800G, lo que recorta más de 550 kilovatios en el sistema de interconexión. El 960E declara 8 EFLOPS en FP8 y soporte para modelos de hasta 10 billones de parámetros, y puede encadenarse en SuperClusters de 512.000 NPUs, con un horizonte final de un millón de procesadores.
Escala en lugar de músculo por chip
La razón de fondo es que Huawei no puede competir chip a chip con Nvidia. Sus aceleradores individuales quedan por debajo de los de la firma estadounidense, así que la apuesta pasa por juntar miles de procesadores y comunicarlos mejor. Es una vía que funciona en términos brutos, pero que Tom’s Hardware matiza: el rendimiento por vatio de estos SuperPoD y SuperCluster sería muy inferior al de las arquitecturas de Nvidia, lo que los hace poco atractivos en mercados con acceso a hardware de AMD o Nvidia.
El propio fabricante reconoce el cuello de botella. Eric Xu, presidente rotatorio de Huawei, explicó en declaraciones recogidas por Reuters que la empresa no tiene capacidad ni para cubrir la demanda china. «Como no tenemos suficiente capacidad para satisfacer siquiera la demanda en China, no tenemos un plan para expandirnos al mercado internacional de forma completa», señaló. Huawei sigue suministrando volúmenes limitados a algunos países con demanda fuerte, pero sin un despliegue global. Xu añadió que cree que la cuota de Ascend en China supera ya la de Nvidia, aunque no aportó datos que respalden esa estimación. La producción de SMIC en nodos de 7 y 6 nanómetros sigue siendo el límite de fondo.
Qué cambia para el lector
Para el comprador europeo o español, el anuncio no se traduce en producto a corto plazo: los Ascend 900 no llegarán de forma masiva al mercado internacional, así que la competencia que notará seguirá viniendo de Nvidia y AMD. Lo relevante es la dirección: China construye una alternativa completa —silicio, interconexión y software— para no depender de las restricciones de exportación de Estados Unidos, y cada generación reduce la distancia en cómputo agregado aunque no en eficiencia. Ese pulso también presiona el precio y la disponibilidad de la memoria que consumen tanto los aceleradores de IA como el PC doméstico. En el ecosistema chino, Ascend 950 ya aparece en las certificaciones de seguridad mientras otras firmas como MetaX colocan su GPU Xiyun C en la nube de China Telecom.