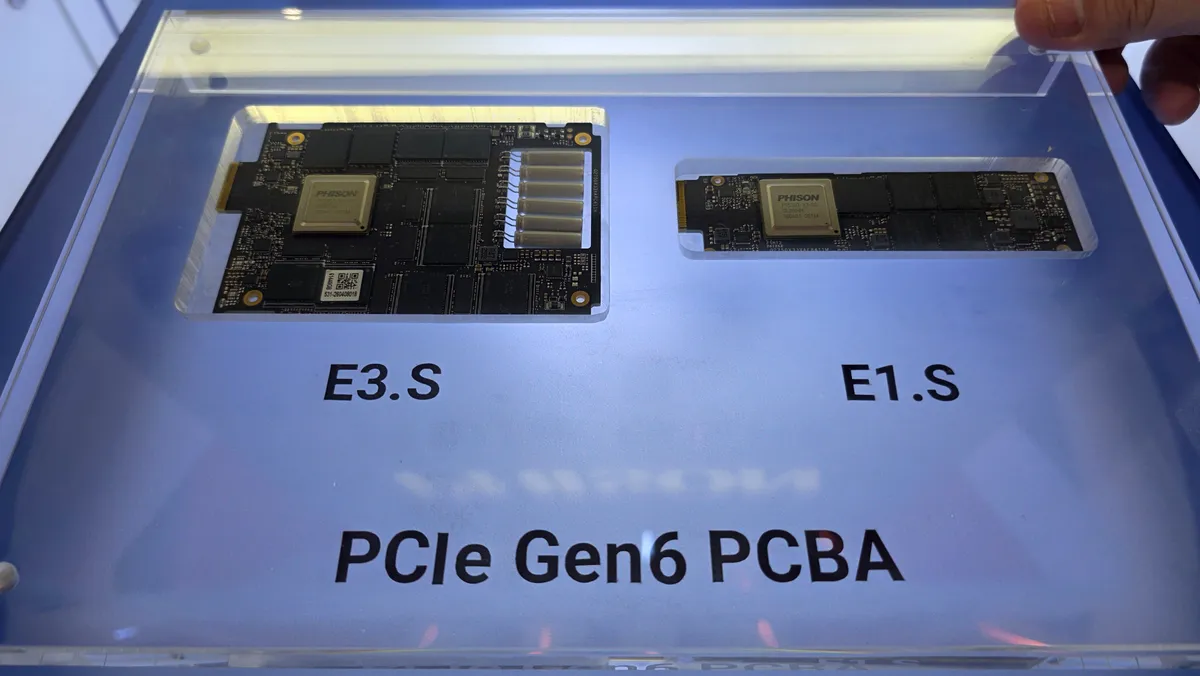
Phison aprovechó Supercomputing 2026, celebrado en Chicago entre el 17 y el 19 de noviembre, para enseñar dos arquitecturas de SSD empresarial que atacan problemas distintos. La primera mete una NPU y 64 GB de memoria dentro de la propia unidad para ejecutar código de IA sobre los datos donde ya están guardados. La segunda coloca la caché pSLC y la capacidad QLC detrás de un único controlador, de modo que cada bahía del servidor aporte almacenamiento útil en lugar de reservarse para discos de caché dedicados.
Conviene fijar el marco antes de seguir: Phison describe ambas como tecnologías en desarrollo y advierte de que muchos de los productos y funciones anunciados llegarán cuando estén finalizados, sin comprometer fechas. Ni el diseño con NPU ni el de medios mixtos tienen nombre comercial, controlador identificado ni fecha de muestras, según recoge Tom’s Hardware. Lo anunciado es la arquitectura; lo demostrado, por ahora, son las cifras que la compañía publica en su nota de prensa. El anuncio se completaba con una tercera línea, el controlador PCIe 6.0 X3 (PS5303), que Phison sitúa en hasta 28 GB/s secuenciales y 6,8 millones de IOPS; esta pieza se centra en los dos diseños de almacenamiento.
Una NPU de 36.800 DMIPS y 64 GB dentro del SSD
El diseño de almacenamiento computacional parte de una premisa sencilla: en lugar de mover un conjunto de datos completo desde el SSD hasta la memoria del servidor y de ahí a la CPU, la unidad lo procesa y devuelve solo el resultado. Phison cifra el ahorro en transferencias de entre 10 y 100 veces para las cargas de trabajo en las que el filtrado o el escaneo dominan el tiempo total, y añade que el procesamiento se hace en paralelo dentro del disco, liberando recursos del procesador anfitrión.
El hardware que sostiene esa idea son tres números: una NPU integrada de 36.800 DMIPS, 64 GB de memoria y un ancho de banda de 130 GB/s entre ese cómputo y esa memoria. En el plano del software, la unidad declara compatibilidad con PyTorch, vLLM, OpenVINO y llama.cpp, de manera que un equipo de desarrollo puede reutilizar sus herramientas en lugar de aprender un entorno propietario.
Los 130 GB/s son internos, no del enlace con el servidor
Esa cifra de 130 GB/s es la que más se presta a confusión, y conviene leerla con la aritmética del enlace delante. Un PCIe 6.0 x4, con 64 GT/s por carril, mueve como máximo unos 32 GB/s por sentido; un PCIe 5.0 x4 se queda en la mitad. Es decir, el caudal que anuncia Phison no puede atravesar el conector: corresponde al bus interno entre la NPU y los 64 GB de memoria de la unidad. La ventaja no está en que el SSD entregue datos más rápido al servidor, sino en que buena parte del trabajo deja de necesitar ese viaje.
Ese planteamiento explica también el tamaño de la memoria. 64 GB son suficiente espacio de trabajo para filtrar, indexar o preprocesar bloques grandes de datos junto al almacenamiento, y para alojar un modelo de tamaño moderado: uno de 8.000 millones de parámetros en FP16 ocupa alrededor de 16 GB. No dan, en cambio, para un modelo grande, y los 36.800 DMIPS sitúan la NPU en el orden de magnitud de un núcleo de CPU moderno, no de un acelerador dedicado. Phison tampoco publica TOPS ni la precisión numérica que admite el bloque de cómputo, dos datos que sí aparecen en cualquier ficha de NPU destinada a inferencia.
La idea de acercar el cómputo al dato no es nueva en el sector: Kioxia ya planteó sustituir parte de la DRAM por SSD ultrarrápidos con CXL, y otros fabricantes han presentado discos que ejecutan el sistema de ficheros dentro de la propia unidad. La diferencia aquí es que Phison habla de ejecutar marcos de IA completos, no solo de aligerar la pila de almacenamiento.
pSLC y QLC detrás de un solo controlador
El segundo diseño responde a un problema de despliegue más que de cómputo. Un servidor de almacenamiento rápido suele reservar parte de sus bahías para unidades de caché de alta resistencia y el resto para discos QLC de gran capacidad, con lo que se paga en complejidad y en espacio. Phison integra ambos tipos de flash en la misma unidad, repartidos en 16 canales y gobernados por un único controlador.
El argumento práctico que da la compañía es la resiliencia de la caché. En una matriz de 24 unidades, perder un disco supone un 4 % de la caché disponible en lugar del 25 % que se perdería si toda la caché viviera en seis unidades dedicadas. El diseño usa NVMe estándar y, según Phison, no requiere software específico en el host, un detalle relevante porque evita cambiar la pila de almacenamiento del servidor.
Lo demostrado y lo que sigue siendo un anuncio
Separar ambas cosas es obligatorio con este tipo de presentaciones. Está publicado y es verificable el desglose técnico: 36.800 DMIPS de NPU, 64 GB a 130 GB/s, soporte declarado para PyTorch, vLLM, OpenVINO y llama.cpp, ahorro de 10 a 100 veces en transferencias para cargas aplicables, 16 canales y reparto de caché entre unidades. También lo está la advertencia de Phison de que todo sigue en desarrollo.
No está publicado, en cambio, casi todo lo que hace falta para evaluar el producto: no hay nombre comercial, ni controlador identificado, ni fecha de muestras, ni cifras de latencia, ni consumo, ni resistencia en TBW, ni precio. Tampoco hay una sola prueba de rendimiento con un modelo real, de modo que el ahorro de transferencias es una estimación del fabricante y no un resultado medido. Frente a un análisis de un SSD de consumo, donde se publican megabytes por segundo sostenidos y límites de caché, aquí solo hay arquitectura y promesas.
Para el lector con un equipo de escritorio, el anuncio no cambia nada a corto plazo: son diseños empresariales, sin producto ni canal de venta. Lo que sí conviene seguir es cómo se resuelve la parte difícil, que es la del software. Que una unidad ejecute PyTorch no implica que el host pueda reservar esa memoria, lanzar el trabajo y recoger el resultado con la misma naturalidad que con un acelerador conectado por PCIe. Si Phison publica ese modelo de programación y unas cifras de latencia bajo carga sostenida, el almacenamiento computacional pasará de idea razonable a algo que se pueda comparar; hasta entonces, es una arquitectura bien explicada y nada más.